|
|
禁止求评分、诱导评分、互刷评分、互刷悬赏值,违规者封号处理。
禁止发布推广、邀请码、邀请链接、二维码或者有利益相关的任何推广行为。
所有非原创软件请发布在【精品软件区】,发帖必须按照本版块版规格式发帖。
本帖最后由 ladinglin 于 2022-9-15 08:07 编辑
最近在学习python,刚接触爬虫章节,在论坛看了不少教程,确实很有帮助,
但是有些文章中都用到了re正则的方式去获取页面中的内容,对于像我这样的新手菜鸟来说,不太友好,
于是,就结合所学实现爬取图片的功能,有不对的,还请大佬多多指教!
功能:指定起始页、终止页爬取、保存图片。
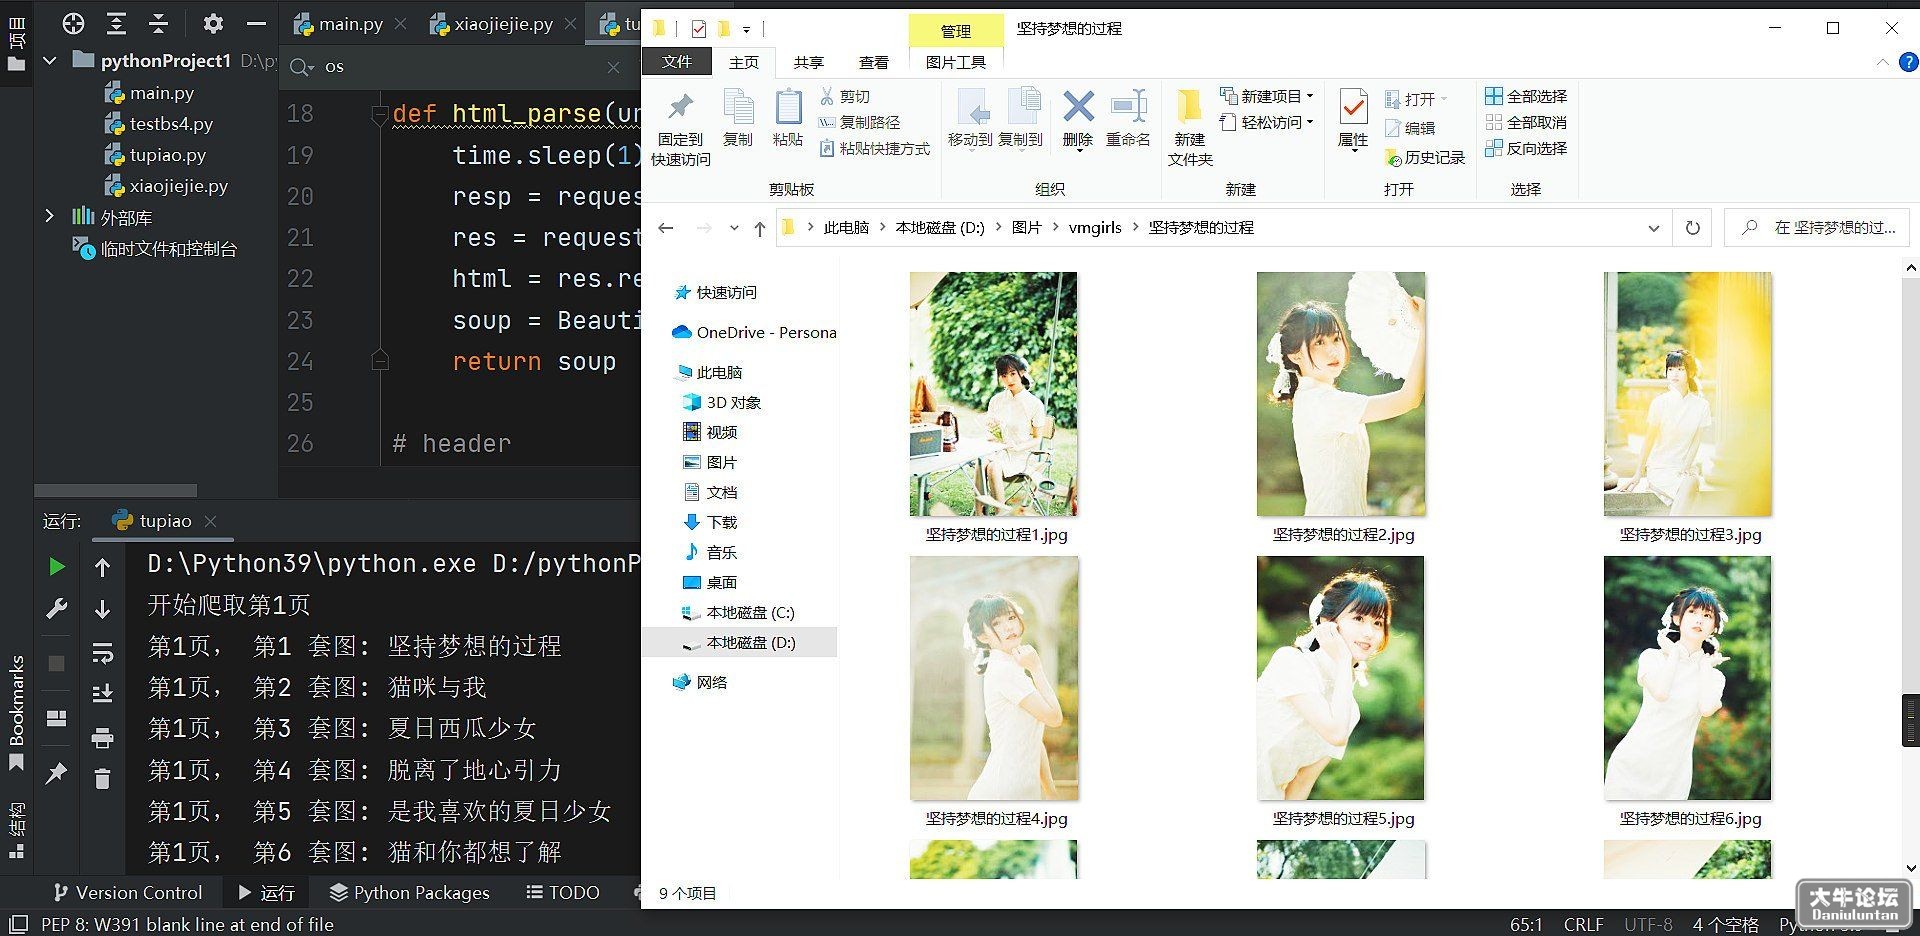
[mw_shl_code=python,true]import os
import time
from urllib import request
from bs4 import BeautifulSoup
# 开始页码
pstart = 1
# 结束页码
pend = 2
# 获取内容
def html_parse(url, headers):
time.sleep(1)
resp = request.Request(url=url, headers=headers)
res = request.urlopen(resp)
html = res.read().decode("utf-8")
soup = BeautifulSoup(html, "html.parser")
return soup
# header
headers = {
'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.114 Safari/537.36 Edg/91.0.864.59'
}
for p in range(pend-pstart+1):
# 次数
if pstart > pend:
break
print("开始爬取第%s页" % pstart)
list_url = "https://www.vmgirls.com/pure/page/%s/" % pstart
page = html_parse(list_url, headers)
alist = page.find("div", attrs={"class": "list-grouped"}).find_all("a", attrs={"class": "media-content"})
for i, a in enumerate(alist, 1):
url = a.get("href")
child = html_parse(url, headers)
title = child.find("h1", attrs={"class": "post-title"}).text
imgs = child.find("div", attrs={"class": "post-content"}).find_all("img")
print("第%s页," % pstart, "第%s" % i, "套图:", title)
arimg = "D:\\图片\\vmgirls\\" + title
if not os.path.isdir(arimg):
os.makedirs(arimg)
for n, img in enumerate(imgs, 1):
pic_name = arimg + "\\" + title + "_" + str(n) + ".jpg"
# pic_name = (title + "_" + str(n) + ".jpg")
request.urlretrieve(img.get("src"), pic_name)
pstart += 1
print("全部爬取完毕")[/mw_shl_code]
|
|



 雷达卡
 发表于 2022-9-15 08:06
 提升卡
 置顶卡
 沉默卡
 变色卡
 照妖镜
 关注公众号